Entiteit- en relatie-extractie
Om grote documenten te verwerken, verdeelt het LLM de tekst automatisch in
delen. Door overlapping blijft de context bij de overgangszinnen behouden.
Elk deel wordt vervolgens naar het LLM gestuurd, samen met een prompt waarin het de opdracht krijgt om
entiteit- en relatie-tripletten te extraheren. Hao Wu heeft een tool ontwikkeld om
entiteiten en relaties uit een korte tekst te halen (Hao Wu,
2025). Het hulpprogramma `ai-knowledge-graph` gebruikt het geconfigureerde LLM van
uw keuze om kennis uit de bovenstaande tekst te extraheren en een
html-bestand met een kennis graaf als uitvoer te genereren.
Voor elk fragment vraagt het hulpprogramma het LLM om een JSON-array uit te voeren
met triples en aan te geven uit welk fragment de informatie is geëxtraheerd.
JSON
(JavaScript Object Notation) is een open standaardbestandsformaat en een formaat voor gegevensuitwisseling dat gebruikmaakt van voor mensen leesbare tekst om gegevensobjecten op te slaan en te verzenden, bestaande uit naam-waardeparen en arrays (of andere serialiseerbare waarden). Het is een veelgebruikt gegevensformaat met diverse toepassingen op het gebied van elektronische gegevensuitwisseling, waaronder die van webtoepassingen met servers.
De standaard wordt beschreven in RFC 8259 STD 90.
We gebruiken de tool van Hao Wu niet, want de hardware daarvoor nodig hebben we niet.
Zie PuppyGraph.
We doen gewoon handmatig wat die tool doet.
Hieronder volgt een voorbeeld hoe de prompt wordt gebruikt:
Return only structured JSON, with no explanation in the form (entity_1, relationship, entity_2) of the following text:
Feedback is a concept from cybernetics. It was introduced and was the subject of heated debate during the Cybernetica conferences of the Macy Group between 1946 and 1953.
These were some of the first structured studies into interdisciplinarity. They formulated new concepts in the fields of systems theory, cybernetics and what would later become known as cognitive science.
[
  {
    "entity_1": "Feedback",
    "relationship": "is a concept from",
    "entity_2": "cybernetics"
  },
  {
    "entity_1": "Feedback",
    "relationship": "was the subject of heated debate during",
    "entity_2": "the Cybernetica conferences of the Macy Group"
  },
  {
    "entity_1": "the Cybernetica conferences of the Macy Group",
    "relationship": "took place between",
    "entity_2": "1946 and 1953"
  },
  {
    "entity_1": "the Cybernetica conferences of the Macy Group",
    "relationship": "were some of the first structured studies into",
    "entity_2": "interdisciplinarity"
  },
  {
    "entity_1": "the Cybernetica conferences of the Macy Group",
    "relationship": "formulated new concepts in",
    "entity_2": "systems theory"
  },
  {
    "entity_1": "the Cybernetica conferences of the Macy Group",
    "relationship": "formulated new concepts in",
    "entity_2": "cybernetica"
  },
  {
    "entity_1": "the Cybernetica conferences of the Macy Group",
    "relationship": "formulated new concepts in",
    "entity_2": "cognitive science"
  }
]
Hiervoor is Google AI gebruikt. Andere LLM's kunnen andere resultaten geven.
Json databanken kunnen bevraagd worden met JSON Query.
Bovenstaand voorbeeld kan eenvoudig worden omgezet naar de proces notatie die Edugraph gebruikt. Als je de grammatica
van de proces notatie nog niet onder de knie hebt, kan het ook automatisch omgezet worden door Edugraph.
name:experiment_triplets
is a concept from [1,2] = Feedback [1] » cybernetics [2],
was the subject of heated debate during [1,3] = Feedback [1] » the Cybernetica conferences of the Macy Group [3],
took place between [3,4] = the Cybernetica conferences of the Macy Group [3] » 1946 and 1953 [4],
were some of the first structured studies into [3,5] = the Cybernetica conferences of the Macy Group [3] » interdisciplinarity [5],
formulated new concepts in [3,6] = the Cybernetica conferences of the Macy Group [3] » systems theory [6],
formulated new concepts in [3,2] = the Cybernetica conferences of the Macy Group [3] » cybernetics [2],
formulated new concepts in [3,7] = the Cybernetica conferences of the Macy Group [3] » cognitive science [7],
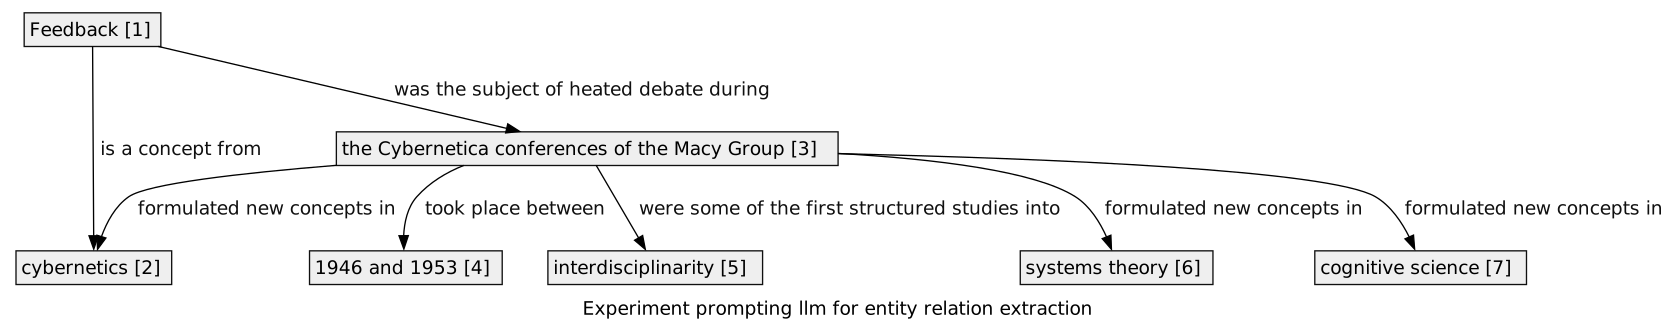
label:Experiment prompting llm for entity relation extraction.
Dit levert de volgende grafiek op:
Ook causale relaties via de LLM prompt
Ook de volgende prompt werkt:Return only structured JSON, with no explanation in the form (entity_1, causal relationship, entity_2) of the following text:
Hij geeft als resultaat:
[
  {
    "entity_1": "Cybernetica conferences of the Macy Group",
    "causal_relationship": "introduced and debated",
    "entity_2": "Feedback"
  },
  {
    "entity_1": "Cybernetica conferences of the Macy Group",
    "causal_relationship": "were some of the first structured studies into",
    "entity_2": "interdisciplinarity"
  },
  {
    "entity_1": "Cybernetica conferences of the Macy Group",
    "causal_relationship": "formulated new concepts in",
    "entity_2": "systems theory"
  },
  {
    "entity_1": "Cybernetica conferences of the Macy Group",
    "causal_relationship": "formulated new concepts in",
    "entity_2": "cybernetics"
  },
  {
    "entity_1": "Cybernetica conferences of the Macy Group",
    "causal_relationship": "formulated new concepts in",
    "entity_2": "cognitive science"
  }
]
Al zou je hier eerder kunnen spreken van "invloed op". Waarschijnlijk passeert dit antwoord de counterfactual test niet.
Nabewerking
Zelfs bij een grondige lezing van de tekst blijven impliciete relaties mogelijk onopgemerkt; Dit ken je op twee manieren aanpakken:
Op regels gebaseerde inferentie:
Transitieve relaties: Als A B mogelijk maakt en B C aanstuurt, dan kan het systeem concluderen dat A invloed heeft op C.
Lexicale gelijkenis: Entiteiten met vergelijkbare namen kunnen worden gekoppeld via een algemene „gerelateerd aan“-relatie.
LLM-ondersteunde inferentie:
Je kan LLM ertoe aanzetten om verbanden voor te stellen tussen subgrafen die anders geen verband met elkaar zouden hebben. Als de ene cluster bijvoorbeeld gaat over de Industriële Revolutie en een andere over AI, zou het LLM een historisch of conceptueel verband kunnen afleiden.
Deze afleidingsstap voegt vaak een groot aantal nieuwe relaties toe, waardoor geïsoleerde subnetwerken aanzienlijk worden verminderd. Je kunt deze stap in het configuratiebestand uitschakelen als je een graaf wilt die uitsluitend op tekst is gebaseerd.